07092009 life
ちょっと欲しいかも
07092009 life
ちょっと欲しいかも
メタモいった。久々のツレとの再会でうだうだしたり、昼を食べてたら、出発するのが遅くなってしもうた。4時くらいに到着したら、行列の長さにげんなり。でも、意外にテント持参のヒトが少なくて、あまり困らずにテントを張れた。
あとテントを設営してたら、テントシール張りっぱなしで4枚目になってた。
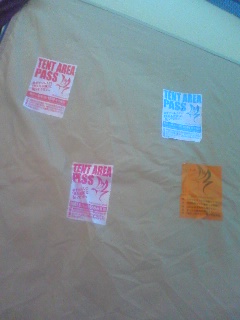
そして、いつものようにミラーボールの近くにテント。 今年は、プラネットステージの上のほう。
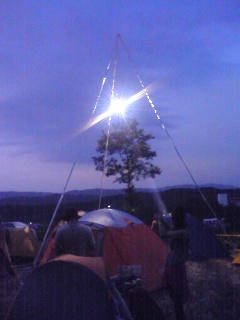
今回はプラネットのうえのほうに陣取ったので、寝ながら聞いてたのが多いが。
なかなかよかった。
return to dragonで。
最初から最後まで。よかった。
しぶすぎ。ラストのReady or Notでやられた。もう少し早い時間がよかったかも。
まったり
 METAMORPHOSE 09
今日の家庭菜園
ジャガイモの芽がでた。

ピーマンと唐辛子。これは順調に実がなってる


島オクラも意外に育ちがいい。モロヘイヤは最近の寒さでバテ気味。
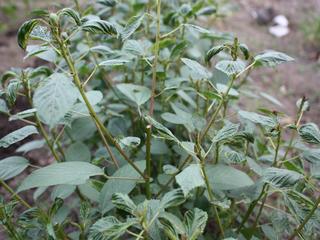
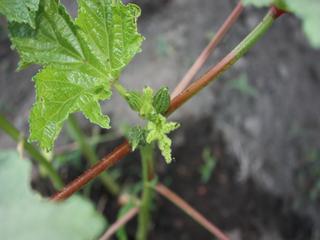
モロヘイヤはもっと早くに植えるべきだった。あまり収穫できずに終わりそう。
05092009 OCaml
openfileとかopen_outとかopen_out_genとか色々あるので混乱する。
let file = Sys.argv.(1) in
let f = try open_out_gen [Open_wronly; Open_creat; Open_trunc; Open_text] 0o600 file
with Sys_error msg -> failwith ("Couldn't write to " ^ msg) in
output_string f "OCaml\n";close_out f;;
04092009 OCaml
03092009 OCaml
最近、表記の本(オンライン)を読みはじめた。
Functional core of Objective CAMLより。
fun a b c d e -> expr
は
function a -> function b -> function c .... -> expr
と一緒らしい。
あーカリー化ってのは結局そういうことなのかと。
多値nをとる関数でなくて引数を一つとってゴニョゴニョする関数を返すから、結局カリー化ってのは自然に導かれんのかと。
って、ふつうのHaskellにも書いてあったな。
03092009 chemoinformatics Python
化学構造の類似度を測るフィンガープリントで部分構造由来のものには2種類あって、ビットにパターンが対応しているものと、そうでないもの。
後者はハッシュ関数とかを使って動的に生成するのでビットの密度の効率が良いが、結局解釈できなくて困ることが多い。
02092009 chemoinformatics R
久々にケモインフォクックブックを更新した。
で、このフィンガープリント使って予測モデルを作ってみる。
Benchmark Data Set for in Silico Prediction of Ames Mutagenicity のSupporting InformationにAmes試験のデータセットがあるのでこれを使ってcsvを用意する。
babel -ismi ci900161g_si_001/smiles_cas_N6512.smi -ofpt ci900161g.fpt -xh -xfFP2
これでfptファイルを用意してクックブックので変換。
f2b.py ci900161g.fpt > fingerprint.txt
さらにフィンガープリントをcsvにするのは下のやっつけスクリプトで。
file = "ci900161g_si_001/smiles_cas_N6512.smi"

dic = {"0":"negative","1":"positive"}
act = {}
for l in open(file,"r"):
   smi,id,num = l.split()
   act[id] = dic[num]


fingerprints_file = "fingerprint.txt"

header = "ID,"

for i in range(1,1025):
   header += "bit" + str(i) + ","

header += "act"
print header

for l in open(fingerprints_file, "r"):
   col = ""
   id, fp = l.split()
   col += "\"" +id + "\","
   for c in fp:
       col += c + ","
   col += "\"" + act[id] + "\""
   print col
実行
python fconv.py > ci900161g.csv
でRで解析してみる。
ames <- read.csv("/Users/kzfm/ci900161g.csv")
set.seed(50)
tr.num <- sample(6512,2500)
ames.train <- ames[tr.num,]
ames.test <- ames[-tr.num,]
ames.svm <- ksvm(act ~.,data=ames.train[,-1])
ames.pre <- predict(ames.svm, ames.test[,c(-1,-1026)])
ames.tab <- table(ames.test[,1026],ames.pre)
sum(diag(ames.tab))/sum(ames.tab)
結果
>     sum(diag(ames.tab))/sum(ames.tab)
[1] 0.7771685
> ames.tab
          ames.pre
           negative positive
  negative     1424      425
  positive      469     1694
まぁまあかなぁ。フィンガープリントとかカーネルを考えればもうちょっと精度が上がる気もするが。
参考
01092009 chemoinformatics
第一部を読んだ。
 Drug-like Properties: Concepts, Structure Design and Methods: from ADME to Toxicity Optimization
これはなかなか名著の予感がしますな。(DMPKやin silicoから見ると)ちょっと浅い気もするが、メディシナルケミスト向けの本だったらこのぐらい押さえておけばいいのかもしれない(というかこの本の内容理解してるケミストって数人しか知らんけど)。
LeadOptimizationから前臨床のあたりのin vivoにおいてどういったパラメータに気をつけながら合成をするか的な内容なので、コンピュテーショナルなヒトだとEkinsなんかを併せて読んだほうがいいかもしれない。
 Computer Applications in Pharmaceutical Research and Development (Wiley Series in Drug Discovery and Development)
 統計のための行列代数 上 (1)
 統計のための行列代数 下 (2)
 藤田智の菜園スタートBOOK 秋冬&春準備編 (生活実用シリーズ NHK趣味の園芸/やさいの時間)
 ケモインフォマティックス―予測と設計のための化学情報学
 マシンラーニング (Rで学ぶデータサイエンス 6)