06122006 東京
新橋から少し歩いたところにあるガネー舎へスープカレーを食べに。 ちと入り口がわかりづらい。

とりカリィを注文。


鶏は柔らかく、野菜はしゃっきり感があってうまい。
が、スパイシーさがもうちょっと欲しいかも。
06122006 東京
新橋から少し歩いたところにあるガネー舎へスープカレーを食べに。 ちと入り口がわかりづらい。
とりカリィを注文。
鶏は柔らかく、野菜はしゃっきり感があってうまい。
が、スパイシーさがもうちょっと欲しいかも。
05122006 DBIC
地道にそれっぽいのを用意しようとするならば、こんな感じ
digraph sample {
   graph [size = "6, 8"];
   graph [nodesep = 0.7];
   node [shape = record, height = 0.01,
         fontname = "Helvetica", fontsize = 9];

   bookmark [label = "{bookmark|id\nname\nuri\ndescription\ntime_created}"];
   tagmap [label = "{tagmap|id\nbookmark_id\ntag_id}"];
   tag [label = "{tag|id\nname}"];

   tagmap -> tag [label = "belongs_to"];
   tagmap -> bookmark [label = "belongs_to"];
   tag -> tagmap [label = "has_many"];
   tag -> tagmap [label = "many_to_many"];
   bookmark -> tagmap [label = "has_many"];
   bookmark -> tagmap [label = "many_to_many"];
}
dotコマンドで実行
$ dot -Tpng db.dot -o db_sample.png
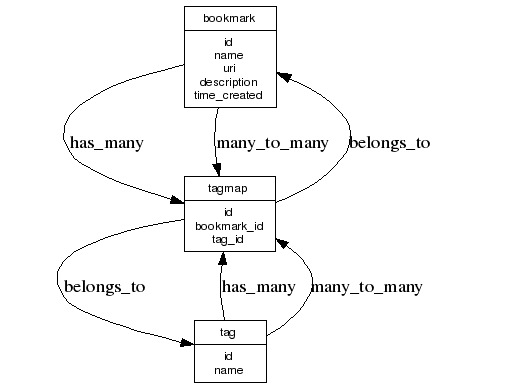
もう少し、スキーマ図っぽくしたいなぁと色々探したらSQL::Translatorというものをみつけた。
後で試す。
04122006 tofu
多対多のサンプルとしてTags: Database schemasの“Toxi” solutionをDBICで書いてみる。
関連を表すテーブルに対しては、1対多の関係を設定しておいて、更にmany_to_manyを追加する
図にしてみたらわかりやすくなった。
ちなみに、1対多はこちらを、多対多はこちらを参考にしました。
use 5.008008;
use strict;
use warnings;
use base 'DBIx::Class::Schema';
our $VERSION = '0.01';

__PACKAGE__->load_classes(qw/Tag Bookmark TagMap/);

1;
use strict;
use warnings;
use base 'Kzfm::Schema';

__PACKAGE__->load_components(qw/PK::Auto::SQLite Core/);
__PACKAGE__->table('tag');
__PACKAGE__->add_columns(qw/id name/);
__PACKAGE__->set_primary_key('id');
__PACKAGE__->has_many(tagmap => 'Kzfm::Schema::TagMap','tag_id');
__PACKAGE__->many_to_many('bookmarks' => 'tagmap','bookmark_id');

1;
use strict;
use warnings;
use base 'Kzfm::Schema';

__PACKAGE__->load_components(qw/PK::Auto::SQLite Core/);
__PACKAGE__->table('bookmark');
__PACKAGE__->add_columns(qw/id name uri description time_created/);
__PACKAGE__->set_primary_key('id');
__PACKAGE__->has_many(tagmap => 'Kzfm::Schema::TagMap','bookmark_id');
__PACKAGE__->many_to_many('tags' => 'tagmap','tag_id');

1;
use strict;
use warnings;
use base 'Kzfm::Schema';

__PACKAGE__->load_components(qw/PK::Auto::SQLite Core/);
__PACKAGE__->table('tagmap');
__PACKAGE__->add_columns(qw/id bookmark_id tag_id/);
__PACKAGE__->set_primary_key('id');
__PACKAGE__->belongs_to('bookmark_id' => 'Kzfm::Schema::Bookmark');
__PACKAGE__->belongs_to('tag_id' => 'Kzfm::Schema::Tag');

1;
制約の部分だけ、考えてみる。
__PACKAGE__->belongs_to('カラム名(アクセサ?)' => 'スキーマ(pm)');
__PACKAGE__->has_many(テーブル名 => 'スキーマ(pm)','カラム名(アクセサ?)');
__PACKAGE__->many_to_many('任意のキー名' => 'テーブル名','多対多関係のカラム');
あと、さらにユーザーを追加する場合に、ユーザーとブックマークも多対多の関係になるけど、こっちも正規化したほうがいいのか、むしろやりすぎないほうがむしろいいのか悩む。
かなりボケボケだった。
こういうことらしい。
DBIx::Class::Relationship - Inter-table relationships - search.cpan.org
PACKAGE>$method_name('relname', 'Foreign::Class', $cond, $attrs);というわけで、こんな感じの理解で。
__PACKAGE__->belongs_to(アクセサ名(任意) =>
    '従うクラス','従うクラスのIDを持つ属性名');
__PACKAGE__->has_many(アクセサ名(任意) =>
    'クラス','自分のクラスのIDをもつ属性名');
__PACKAGE__->many_to_many(アクセサ名(任意) =>
    'has_manyでのアクセサ名','belongs_toでのアクセサ名');
データベースを指しているのかクラスを属性を指してるのか良く分かってなかった。というかO/RマッパーでDBのカラム名っておかしいよって何で気づかなかったんだろう。
なんとなくこんな感じか。
04122006 blosxom
あるとわかっているのに辿りつけないもどかしさというか、
google 検索結果返す 故にエントリ有り
というようなgoogle認識論的なアプローチに依存しすぎるということはちょっとツライことに気付いた。
ちゅうのは、自サイトの検索をgoogleに任せてからそこそこ経つんだけど、googleは被リンク数が少ないと(クローラーはガッツリ持ってくくせに)検索結果の表示対象にならない。そのため、自分で書いたエントリがあるはずなのに探せないという状況が頻発した。
なんで、やっぱ自前で検索エンジン入れる必要があるなぁと、Hyper Estraierを利用して検索できるようにした。
僕のサイトはblosxomで構築されている。これは、データベースでなく普通のテキストファイルでエントリを管理しているので、Hyper Estraierのestcmdでデータディレクトリを検索対象にすればよい。ただし、これだと、タイトル属性がないために、検索結果のタイトルがファイル名になってしまう。
blosxomのエントリデータは先頭行がタイトルのテキストデータなので、ここら辺をちょっといじくるblosxom用のフィルタを作成した。
まずは、フィルタを作成。/usr/local/share/hyperestraier/filterのestfxpdftohtmlをコピーしてフィルタを作成。下はdiffってみたけど、要するにpdftotextのコマンドをblosxom用のコンバートコマンドに書き換えれば良いだけ。僕の使っているestfxblosxomtohtml。
--- estfxpdftohtml      2006-12-02 16:09:34.000000000 +0900
+++ estfxblosxomtohtml  2006-12-02 17:47:04.000000000 +0900
@@ -1,14 +1,14 @@
 #! /bin/sh
 #================================================================
-# extfxpdftohtml
+# extfxblosxomtohtml
 # Convert PDF into HTML
 #================================================================

 # set variables
 PATH="$PATH:/usr/local/bin:$HOME/bin:." ; export PATH
-progname="estfxpdftohtml"
+progname="estfxblosxomtohtml"

 # check arguments
@@ -56,7 +56,7 @@

 # output the result
-pdftotext -enc UTF-8 -htmlmeta "$infile" - 2> "/dev/null" | output
+bldata2html "$infile" - 2> "/dev/null" | output

 # exit normally
で、blosxomのデータをhtmlに吐くには先頭行だけtitle属性で囲んで、あとはそのまま出力すればいいんだけど、僕はmarkdown使っているので、フィルタリングしてhtmlに出力するようなスクリプトにした。これがpdftotxtにあたるbldata2htmlで/usr/local/binとかのパスの通ったところに保存する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | #!/usr/bin/perl use strict; use warnings; use FileHandle; use Text::Markdown 'markdown'; my $filename = shift; my ($title,$body) = (); my $fh = new FileHandle($filename); $title = <$fh>; chomp($title); { local $/ = undef; $body = <$fh>; } my $html = markdown($body); print "<title>", $title , "</title>\n", $html; |
あとは、実際にインデックスをつくる。txt属性はestfxblosxomtohtmlフィルタをかますようにオプションを指定しておく。最後のextkeysは検索速度向上のため。
PATH=$PATH:/usr/local/share/hyperestraier/filter ; export PATH
estcmd gather -il ja -fx ".txt" "H@estfxblosxomtohtml" -sd casket /var/blosxom/data/
estcmd extkeys casket
で、実際にestseekで検索するといい感じ。後は定期的にインデックスの更新するようにしとけば、自サイトの検索はOK。今のとこ、cronでインデックスの更新するようにしていないので、blosomの検索フォームはgoogleのままだけど、そのうち変更しよう。
あとは、blosxomのエントリに類似エントリ検索をした結果を表示するプラグインを作っておけば便利かな。
markdownは行の先頭にスペース4文字を入れればcodeブロックになるので、
perl -ne 'print " " . $_' file
とやった出力をblosxomのエントリにペーストしてるんだが、もうちょい楽な方法はないもんだろうか?
とか思った。
01122006 TT
TT使ってできたHTMLのソースを見ると、IF文の部分とかが空白行になってしまい、やたらとスカスカ全開のHTMLが気持ち悪かったりして、コードの見やすさを犠牲にして、改行を削ってJAPHみたいなあとから読んだらよくわからんようなTT作ったりたんだけど、、、
-をつければchompして空白行を消すことができるということをCatalyst::Manual::Tutorial::CatalystBasicsで知った。
[% FOREACH book IN books -%]
  <tr>
    <td>[% book.title %]</td>
    <td>[% book.rating %]</td>
    <td>
    etc,etc
    </td>
  </tr>
[% END -%]
</table>
とかやっておくと
      </tr>

    </table>
といった、いかにもな感じの空白行が
      </tr>
    </table>
まるで手術痕の残らないヨみたいな自然なソースになるわけだ。素敵!
ま、ちょっと探したらTemplate Toolkit Manualにも書いてあったので、単にマニュアル読んでないのがばればれなだけなんだけど、、、、
Template Toolkit Manualもちゃんと読んでおくべきか。
で、微妙に本も欲しくなったりするなぁ。
とはいうものの、TTに深入りするくらいなら、HTML::Masonみたいなほうが僕にはむしろあっているのかナァと悩んだが、テンプレートはテンプレートの利便さを追求する結果、うっかり高機能化した(しすぎた)だけなんだヨって考えるほうが、MVC的には自然なのかなあと今は考えている(というか自分を納得させている)。
01122006 catalyst
久々にtelnetしたマシンでcatalystをいじってたら、TTSiteがうまく動かず、おかしいなぁ~と思ってたら
Catalystのバージョンが5.6902だった
このバージョンでTask::Catalyst 1.90を入れたので、エラーメッセージを吐かずに真っ白画面を出力していた模様。
Catalyst 5.7006にバージョンあげたらちゃんと動いた。
で、TTSiteだけど、普通に使うTTのヘルパーモードだと
app_create.pl view TT TT
で、TT.pmを作ってくれるだけなのに対してTTSiteは、
app_view TT TTSite
とやってヘルパーさんを動かすと、ヘッダー、フッターとかのテンプレートの雛型も一緒に作ってくれるという、お手軽度50%増量みたいな感じらしい。さらに、コントローラのディレクトリ構成とテンプレートのディレクトリの構成が対応するっぽいのでテンプレートが増えたときに把握しやすいのかも。
っていうか、これから使おうとしているのでまだちゃんとわかってないけど。
あとは、TTSiteだと拡張子がtt2になるので、Meadowのttモードも動くように.emacsに設定を追加しておく。
(setq auto-mode-alist
     (cons
       '("\\.tt2$" . html-helper-mode) auto-mode-alist))
30112006 catalyst

 Perl Template Toolkit