26042006 bloglines
左手の人差し指をjに小指をsに置くと片手でbloglinesを操作できることに気がついた。
これで、右手でサンドイッチとかおにぎり食べながら、blogのチェックができるので便利だ。
26042006 bloglines
25042006 東京
茗荷谷と新大塚の間くらいにある兵右衛門に行ってきた
醤油ラーメン
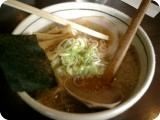
麺は太めでもっちり感がある。スープは醤油が強め。あと酸味も結構あったので、魚介も結構加わってるのかな。あと背脂結構浮いてたが、あってもなくてもというか、むしろスープにコクを加えてもらったほうが。
麺がなかなかだったのでつけ麺のほうがいいかな。
25042006
word文書って結構使いにくい、というか印刷するときしか役に立たない。けど、職場の文書ってほとんどwordなんだよな。報告書とかrssで新着チェックさせるようにしてるけど、descriptionの中身がないから、結局リンクをたどってwordを起動して文書をみないといけない。
で、descriptionにwordの内容を突っ込むために、wvWareを入れてみた。htmlで出力させたwordファイルをCDATAセクションに埋め込んで、全文配信すればかなりいい感じ。
あとはそういう文書はIISのマイクロソフト漬けなので--ntlmオプションを付けて認証を通したりとかする必要があったりとか。
そうそう、
ITmedia News:ゲイツ会長「Web2.0はあまりにあいまい」
「さらに重要なのは、それらのソフトをネットで利用できる環境やプラットフォームを構築すること」と指摘し、同社のプラットフォーム上でWebサービス各社にさまざまなサービスを展開してほしいと語った。
とかいって、また独自路線にこだわるの遠慮して欲しいナァ。いまだにFrontPageで作られたへなちょこHTMLがわんさかあって非常に困る。
FrontPageって最近のバージョンはどうなんだろうか?相変わらず閉口するくらい汚いソースを出力するのかな?
23042006 blosxom
なんかページング処理でバッティングしてると書いたが、いろいろいじってみてやっぱそうっぽい。
余談だが、いろいろいじった挙句、ページングの処理用プラグインがyoshitakaからpagingに変更になった。
override_num_entriesプラグインはstartの処理で表示件数を書き換えるんだけど、pagingとかyosshitakaはそのあとさらにエントリ数を書き直してしまってるみたい。
というわけで、pagingプラグインのstartの処理のところで、
if (!-d $currentpath or $blosxom::path_info_yr or
$ENV{'REQUEST_URI'} =~ /index.xml$/) {
    return 0;
  }
なんてしといた。
index.xmlは生成するのに1分くらいかかってるから、どうにかしないとな。負荷対策としては、昔のエントリはblosxomで生成するXMLとは別に静的なファイルを作成してsitemapに登録しておくのがいいのかな。で、最近のエントリだけindex.xmlで吐き出すようにするとか。spamトラックバックでdynamic_cacheがrecacheされてしまうのもどうにかしないといけないな。
22042006 perl
夕方、探しに本屋にいったんだけど、悲しいかな、ここは田舎。さすがにまだ発売されてなかった。でもvol31が置いてあったのでパラパラめくって帰ってきた。はやくこっちでも発売されんかな。
404 Blog Not Found:perl - 勝手に添削 - WEB DB Press Vol.32 pp.94
Damianも言っていたように、「ソースコードは未来の自分へのラブレター」なのだ。
上の勝手に添削エントリは勉強になった。
まずは定数の扱いから。オリジナルではuse constantを使っていたが、これは駄目である。use constantの「定数」は、実は定数を返すsubなので、sigil ($@%&*)が定数から消えてしまう。
PerlBestPracticeでもReadonly使えって書いてあったけど、理由がようやくわかった。ついでに両方ソースを眺めといた。TIE(SCALAR|ARRAY|HASH)の
my $whence = (caller 2)[3]; # Check if naughty user is trying to tie directly.
ここのとこがイマイチわかってないのであとでちゃんと調べる。
いつuse CGI qw/:standard/を使うかというのは、実はnon-trivialな質問なのだけど、このようにCGIモジュールの中だけで文字列生成が完結する場合には、use CGI qw/:standard/などを使って余計な$q->を省き、テンプレートなどを使って処理が別になっている場合は、$qを使って処理を渡すというのがきれいかつわかりやすい切り分けだと思う。
恥ずかしながら、use CGI qw/:standard/の使い方を初めて知った。昔から使ってるけど、そのころはperldoc読めなかったしナァ。
22042006
僕はGYAOを意外にみている気がする。きっかけはエウレカなんだけれども。showtime使いだして、その流れでなんとなく。で、全国うまいラーメン図鑑 もなかなかいい。ヒコマロ以外は素人丸出しのレポなんだけどそれはそれでなかなか。
でもfirefoxでアクセスするとWindowsMediaPlayerのバージョンが古いとか出るのはいただけねぇ。うっかり、MSから最新版(つっても2004年のを)ダウンロードしてから、ふと、
それはおかしいだろ
ってことに気づいた。IEからじゃないと視聴できないだけだったね。
21042006 Meadow javascript
javascriptで色々やってみたいことがあるんだけど、、、、
javascript全然わからん
いや、まぁ簡単なAjaxのスクリプトとかはわかるし、いじれるんだけど、オブジェクトとかイベントとか使った処理がちとあやしい。 結局、体系的なのがわかっていないのかなぁというわけで、こそっと勉強してます。
ここの1部で基本を学ぶ。特に8章のオブジェクトの章がよかった。
さらにサンプルとして拾い読みしているjsファイルをMeadowで読みやすくしたいナァとJavaScriptによるオブジェクト指向プログラミング からjavascript-mode.elをダウンロード
.emacsにこんな設定をしとくと、.jsファイルを開くとjavascript-modeが起動
;; javascript-mode
(autoload 'javascript-mode "javascript-mode" "JavaScript" t)
(setq auto-mode-alist
      (cons
       '("\\.js$" . javascript-mode) auto-mode-alist))
で、この勢いでprototype.js読むぞとなるわけだ。
21042006 bioperl
どうでもいいひとにとっては些細なことかもしれんがBioperl Users Group in JapanがPHPなのが気になった。
KWIKIとかFreeStyle Wikiとかのperlなwikiという選択肢はなかったのかにゃ。
biophpってあんのかな?とかおもったらあんのね、びびった。
あと、Ajaxとかそんな処理するためにbioprototype.jsとかあればええなぁ。マルチプルアライメントの結果のアミノ酸onmouseoverしたら対応する立体構造の領域がハイライトするとか。そんな素敵なライブラリがあればええかも。
20042006 blosxom
ずっとfindプラグインを使ってきたんだけど、エントリが増えてきて結構負荷がかかるようになってきたのと、たまにロボットが検索たどりやがると非力なうちのサーバーがスワップするのが気に入らんので、google検索に切り替えた。
JavaScriptを用いてサイト内検索を参考にonSubmitイベントでsite:kerolin.jspeed.jpを追加するようにしたので、検索はOK
あとはGoogle サイトマップでもれなく巡回させるようにすればいい。
Ck2BloggerのようにGoogleSitemaps用のXML吐くフレーバー用意して、Ck2Bloggerを参考にoverride_num_entriesを導入したが、うまく件数の調整ができず。
なんでかなぁと、小技Tipsみたいに環境変数で設定ファイルをいじってみたけどこれもだめ。
どうも、ページングで使っているyoshitakaプラグインの気が。とりあえず今日はココまで。
20042006 R
一年くらい前の下書きエントリが残っていたのでまとめてみた。ちなみに僕は会社に入ってから統計覚えたにわか(エセ?)スタティシャンで、お気楽統計が好き。t検定とかF検定とかほとんどやらない。むしろSVMとかベイズとか好んで使います。もちろんPCAとかで空間にマップするのもみて面白いんで、テキストマイニングも大好きだ。
というわけでちょっと、偏ってるかもん。
自分の過去のエントリ見てみると、perlからRを呼び出してつかったり、scipyとかnumpyに惹かれてるようだけど、視覚化ツールとしてのRも結構好き。
ファーストチョイスはこれ。
Rの使い方の本だ。実際にRで動かして感触を得ながら読み進めていくのがよいかと。数値計算に関する話とか、行列計算とか丁寧に書かれているので理解しやすい。あとplotなんかの例が豊富で、それがまたRをいじる気にさせるわけだ。僕は15章のグラフィックスが一番役にたった。
そして、わからないとことか深く調べたいときにはRjpWikiで調べればよい。
欲を言えばオライリー本みたいにいい紙使って欲しかった(ちょっと重い)。
こちらは、Rの使い方を懇切丁寧にというよりは、初歩の統計をRのコードを交えながらという感じ。
感覚としてはperldocみたいに知りたいとこだけ知るにはいい感じ。だいたいRの使い方わかっていればperldocのSYNOPSISのように必要最低限記述してあるほうが使い勝手がいい。
名前にだまされたとかでアマゾンではいい点ついてないけど、僕は★★★★☆ぐらいかな。確かにR初心者で懇切丁寧な本を探してる人にはどうかなぁとは思う。あとは普通に統計学学んでる人にも書いてる内容が基本的すぎてつまらないのかも知れない。
でも、H2L(Hit-to-Lead)とかLO(Lead Optimization)に関わっててQSARとは違う切り口で統計的な手法なんか使ってみたいなぁ。とか思っている人にはいいかもよ。(明らかにアッセイ条件しくってて)R2ボロボロでシグモイド曲線もよれててカテゴリカルなんじゃね?って思うのに、IC50きっちり出しといたとか言い張られると、後ろでこそっとノンパラ検定やりたくなるでしょ、奥さん。みたいな。そんな時A5なサイズで厚みもそんなにないこの本をこっそり登場させると吉だ。
まんま事例集。最初のほうに初級者用の章があるがあんま役にたたん。この手の本にインストールのやり方書く必要あんのか?むしろpdfにしてCDに突っ込んどけばなんて思ってしまう。あと、想定されてる読者層がいまいちわからない。というのは、イントロダクション的な内容があったり、パッケージの作り方が書いてあったりとか、内容が盛り込みすぎなんだが、節操がないんだかわからんような構成で、質がまちまちなのは著者が章ごとにバラバラだから仕方ないのかな。正直1部に章を割く必要あるのかpdfで(以下略)
一応、16章がBioconductorの章になってんだけど、十数ページしかないし、マジにイントロだけなのでちょっとRでバイオインフォじゃ!みたいなノリで読むと物足りないこと間違いなし。スポッポファイアの事例集のが役に立つかなぁ。
むしろ参考になったのが
5章の時系列解析は、HTSなんかのマシンの癖によるエッジ効果っていうかバギーなウェルのチェックとか、経時変化による細胞のへたり具合分析ルーチン書いたりする際に参考になった。
6章8章が役に立ったのは、主にケモインフォで。カテゴリカルなデータとかバイナリなデータはケモインフォな記述子いじる場合避けては通れないし、タニモト係数で評価すんのはちょっとなあって時にロジスティック回帰などいいかと思う。まぁそんなときにはまずベイズ推定したりすることのが多いけどな。
あと、画像処理で遊びたいナァと思っているので8章も参考になった。
Rの入門書としてはどうかな?むしろアイデア頂いたりとか、新しい統計手法に触れたりとか、アイデアブックとして使っている。
 JavaScript
 The R Tips―データ解析環境Rの基本技・グラフィックス活用集
 Rによる統計解析の基礎 (Computer in Education and Research)
 The R Book―データ解析環境Rの活用事例集