Recursive Feature Elimination

文献あさってたらrecursive feature eliminationというSVMから記述子の重みを推定するらしき方法を見つけたのでRでできんもんかと探した。

結局探せなかったんだけど、Feature Selectionのためのツールを少し見つけたのでメモ。

Looking for packages to do Feature Selection and Classification

  • random forest (varSelRF)
  • caMassClass

あと、バイオインフォでもやっぱ使われてるのね。後で読もう

プリチャードの読学紀行 : Regularized Least Squares Cancer Classifiers from DNA microarray data

Classifier の中でもSVM とRegularized Least Squares (正則化最小二乗法)を比較した文献。 正則化最小二乗法はを使うことでSVMでの計算量の多さを低減し、未知のサンプルの遺伝子発現が少ない際に、その利点を発揮する、ということらしい。

Catalyst::Example::InstantCRUD

CatalystのML見てたらDBICベースのCRUDフレームワークもあるそうな。

  • Enzyme
  • CDBIベース
  • modelやcontrollerのヘルパースクリプトで指定
  • Catalyst::Example::InstantCRUD
  • DBICベース
  • HTML::Widgetもつかっとるよ
  • catalyst.plの代わりにinstantcrud.pl

というわけで、手持ちのmysqlのデータベースでやってみた。

$ instantcrud.pl -name=Kz::Sample -dsn='dbi:mysql:kzsample' -user=kzfm
-password='test'

こんだけ。

あとはサーバー起動するだけで超ラク!

でも、遺伝子発現DBでやってみたら、

$ instantcrud.pl -name=My::Exp -dsn='dbi:SQLite:myexp.db'

Caught exception in My::Exp::Controller::Expressions->list 
"DBIx::Class::ResultSet::search(): no sth generated via sql: 
SELECT me.id, me.affyid, me.d0, me.d2, me.d4, me.d10 FROM 
expressions me LIMIT 10 at 
/usr/lib/perl5/site_perl/5.8.3/Catalyst/Example/Controller/InstantCRUD.pm line 220"

とエラー。そもそもDBICちゃんとわかってないので、これ以上はちょっとな、、、ってことでヤメ。

Catalystにも幾つかCRUDフレームワークがあることがわかったのでよしとしよう。

CatalystとGD::Graph::linesで作った遺伝子発現データベース

Ruby on Railsで、遺伝子発現データベースを!というエントリがすんげー面白かったので、ここはひとつperlなcatalystでやってみたヨ。

ichan::Weblog - Ruby on Rails Gruffを使って、11分で作る遺伝子発現データベース

ごく簡単な遺伝子発現データベースをRuby on Rails で作ってみました。時系列の遺伝子発現データを取りこんで、Gruffで折れ線グラフで表示します。bioinformaticsやマイクロアレイ解析と関係がないかたもGruffの使用例として参考になると思います。

一応、10分でできるRoRなやつをトレースしたことがある。なんで、今回ムービーも見ながら、できるだけ同じような感じで構築してみた。ちょっとCatalystとRoRの対比をしておきますと、

RoRはレールにのっかってスイスイッと。特にDBまわりとの連携がすごく楽。対してCatalystはページングの処理とかプラグイン使わないといけないし、フォームの用意も自前でやらないとあかん。 画像吐き出しはRoRはコントローラで処理しているが、CatalystはViewに押し込んでいる。GD使うつもりだったけどTTでGD呼ぶのは抵抗があったので、Catalystのプラグイン探したけどなかった。そんなわけで結局、画像処理はTTのGD::Graphプラグインで行なってます。

個人的な見解だけど、RoRは定型的な処理は楽ちんっぽいです。CatalystだとページングにClass::DBI::Sweet使うかClass::DBI::Pager使うか悩んだり、Class::DBI::Sweetのヘルパーないかと探し回ったりと、コードの長さの割りに時間がかかってしまった。でも、viewに画像処理押し込むとコントローラーいじらなくてすむのでそれはそれでいいのかな?

さて手動かし履歴(かなり端折ってますが)

まず、発現データの処理とDB化は元ネタサイトどおりにbioconductorで。スクリプト動かしたら、パッケージ足りなかったので

source("http://www.bioconductor.org/biocLite.R") biocLite(c("mgu74av2cdf"))

を。あと、Rでapllyを使うと早いのね、勉強になった。今度他のデータで試してみよう。

$ catalyst.pl Expview
$ cd Expview
$ ./script/expview_create.pl view TT TT
$ script/expview_create.pl model CDBI CDBI dbi:SQLite:myexp 

これだと、ページングの処理が出来ないので、lib/Expview/Model/CDBI.pmに

use Class::DBI::Pager;

を追加。

そしてコントローラーまわりをいじる。lib/Expview/Cotroller/Root.pmを編集


sub list : Global {
    my ( $self, $c ) = @_;
    my $page = $c->request->param('page') || 1;
    my $pager = Expview::Model::CDBI::Expressions->pager(10,$page);
    $c->stash->{items}  = $pager->retrieve_all;
    $c->stash->{prev_page}  = $page-1;
    $c->stash->{next_page}  = $page+1;

$c->stash->{template} = "templates/view.tt";
    $c->forward('Expview::View::TT');
}

sub graph : Global {
    my ( $self, $c ) = @_;
    my $id = $c->request->param('id');
    my $exp = Expview::Model::CDBI::Expressions->retrieve($id);
    my @expression = ($exp->d0,$exp->d2,$exp->d4,$exp->d10);
    $c->stash->{exp} = \@expression;
    $c->stash->{affyid} = $exp->affyid;

$c->stash->{template} = "templates/graph.tt";
    $c->forward('Expview::View::TT');
}

こんな感じで、リスト用のルーチンと画像表示用のルーチンを記述。TT用のテンプレートもroot/templatesに用意します。

これでOK

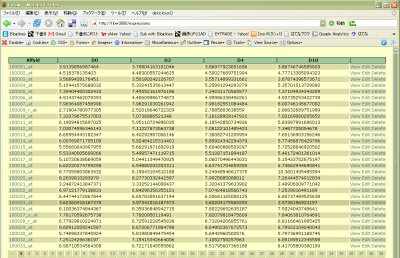
リストはこんな感じで表示されますが、Catalystは自前でテンプレート書かないといけないのに対して、RoRはそこも面倒見てくれている。この部分のコストはお気軽さに結構きいてくるかも。
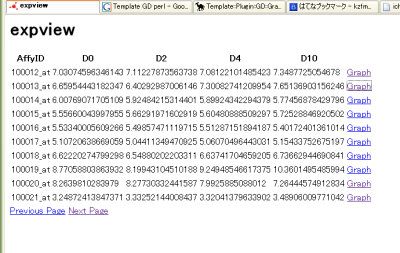
expview

画像もGD::Graphで。ちょっと見栄えがよくないが、でもテンプレートいじれば綺麗になるヨ。
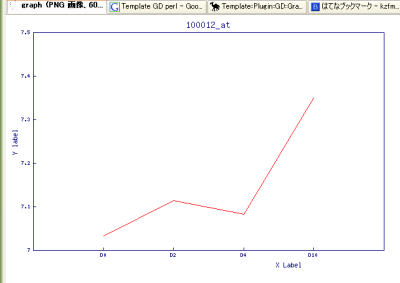
expgraph

今回作った、expview.tar.gzをダウンロードできるようにしておきました。

$ tar xvfz expview.tar.gz
$ cd Expview
$ ./script/expview_server.pl

でport3000番にアクセスすればいいはず。

5/15追記

Catalyst::EnzymeというCatalyst用CRUDフレームワークを使えば、テンプレートとかCRUDまわりをまとめてやってくれるので、10分くらいでできそうな感じデス。
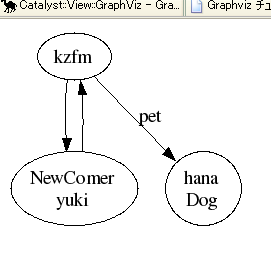
Catalyst::View::GraphVizを使ってみた

Catalystの画像描画モジュールを探し回ってたときに見つけて面白そうだと思っていた、Catalyst::View::GraphVizを使ってみた

まずはインストール。GraphVizのサイトにRPMがあったのでそれを利用した。perlモジュールはcpanから。ちなみにGraphVizモジュールの作者はYAPCで公演してた。

$ rpm -Uvh /home/kzfm/graphviz-2.8-1.fc1.i386.rpm 
$ rpm -Uvh /home/kzfm/graphviz-devel-2.8-1.fc1.i386.rpm 
$ cpan -i GraphViz
$ cpna -i Catalyst::View::GraphViz

さて、ここからcatalyst

$ catalyst.pl Gview
$ cd Gview
$  ./script/gview_create.pl view GraphViz GraphViz

ってやって、Root.pmをいじるが、とりあえずデフォルトで出力させてみた。

sub default : Private {
    my ( $self, $c ) = @_;
    my $g = GraphViz->new();

$g->add_node('kzfm');
    $g->add_node('yuki', label => 'NewComer\nyuki');
    $g->add_node('hana', label => 'hana\nDog');

$g->add_edge('kzfm' => 'yuki');
    $g->add_edge('kzfm' => 'hana', label => 'pet');
    $g->add_edge('yuki' => 'kzfm');
    $c->stash->{graphviz}->{graph} = $g;

if(!$c->res->body) {
        if($c->stash->{template}) {
            $c->forward('Gview::View::TT');
        } elsif($c->stash->{graphviz}->{graph}) {
            $c->forward('Gview::View::GraphViz');
        } else {
            die("No output method!\n");
        }
    }
}

GraphViz

タグの関係を視覚化したり、スキーマ書いたり色々使えそう。論文とか化合物の類似性の視覚化とかでもいいいかも。階層クラスタリングが見にくい場面とかでこういった方法取れるかな。

Catalyst使わないでblosxomのタギングプラグインに組み込むというのもありかな。image mapでだせるのでおもろいかも。

Ajax使ってる例もあったので、Catalyst+Prototype.jsでやるのも面白いかと思ったり。

Catalyst::Enzymeでかなり楽ができる

CatalystとGD::Graph::linesで作った遺伝子発現データベースでCRUDメンドイとかいたたがCatalyst::EnzymeというCatalyst用CRUDフレームワークがあったので使ってみた。

CatalystにEnzymeなんて、バイオインフォ+ケモインフォな僕にはソソル名前のフレームワークだヨ。

$ catalyst.pl Eview
$ cd Eview/
$ ./script/eview_create.pl view TT Enzyme::TT
$ ./script/eview_create.pl model MyExp Enzyme::CDBI dbi:SQLite:dbname=db/myexp.db 
$ ./script/eview_create.pl controller Expressions Enzyme::CRUD MyExp::Expressions

とかやって、テストサーバー立ち上げるとこんな感じで。

Expview

かなり、楽チンだ。

Catalyst::Enzyme - Catalyst用CRUDフレームワーク

前提条件

アプリケーションがClass::DBIベースのモデル・クラスを使っていること。

アプリケーションの一部として(たぶん内部用の管理インタフェースとして)、あるいは単に何かのとっかかりとしてCRUD機能を使いたいと思っていること。

(コードにしろテンプレートにしろ)修正するためにソースを読んで理解しようとする気構えがあること。Enzymeを使えばいままでより速く、また少ないコード量で始めることはできますが、その後、自分自身の用途にあわせたフレームワークへと作り込んでいく必要はあるのです。自分の必要に応じてどんどん変更していってください。

特に最後に書いてあるように、ソース読めないと作りこみではまるかもしれん。

CDBIで日ごとに集計をとりたいが、、、、

Class::DBIでMySQLのDatetime型を日付で集計ってどうやるんだろうか?

つまりはこういうことがやりたいんだけど。

mysql> select substring(subdate,1,10) as date,count(*)
mysql> from items group by date;
+------------+----------+
| date       | count(*) |
+------------+----------+
| 2006-04-26 |       15 |
| 2006-04-27 |        2 |
| 2006-05-01 |        5 |
| 2006-05-02 |        1 |
| 2006-05-09 |        2 |
| 2006-05-10 |        1 |
| 2006-05-11 |       37 |
| 2006-05-12 |        2 |
+------------+----------+

こいつを棒グラフとか折れ線グラフで画像に書き出してやろうと思ったんだけどナァ、、、、

やっぱset_sqlなのかな。

Algorithm::Cluster

Algorithm::Clusterはちょっと面白そうかな。 まだちゃんといじってないからなんともいえんがexsample動かしてみた限りでは読みやすいし、出力もよさげな感じ。そして、Rを動かすよりも速い気がする。

マニュアルはココとかココ

発現プロファイルとかというよりは、文書中の単語の頻度プロファイルとか比べたりとか、タグを持っている文書群缶の距離を調べてそれを図にしたりとか。まぁそれってPCAでいいような気もするが。

SOMとかk-means clusteringが出来るのも嬉しいかも。あー試してみたい。

うーん。となると、データ収集のためのインフラが欲しいナァ。

亀田兄弟の試合でやたら目立ってたな京楽

試合はほんまおもろかったが、気になったのは、

ぱちんこ亀田3兄弟

でるよな、、、、、多分。そして出たら、多分やりに行くかも。

京楽って「たぬ吉くん」のメーカーなのね、懐かしい。

Class:DBI::AutoLoader

mixiみとったら、Class::DBI::AutoLoaderがわかんないとかいうトピックをみっけた。

自動的にサブクラスを作ってくれるらしい。サブクラスの命名則は文字数字以外をsplitして最初の文字を大文字にして連結。

$table = join('', map { ucfirst($_) } split(/[^a-zA-Z0-9]/, $table));

おー、これは便利そうだ、いったいどうやってるんだ?とコードを眺めてみたら、importメソッドからgenerateClassを呼び出して、eval($class)でサブクラスを作ってるみたい。

で、importってドコで呼ばれんの?

ってことで少し調べてみたら、 続・初めてのPerlの12章に書いてあった。

use My::Module qw(kzfm hana yuki);

は以下のコードと等価

require My::Module;
My::Module->import( qw(kzfm hana yuki) );

ProductName 続・初めてのPerl - Perlオブジェクト、リファレンス、モジュール
Randal L.Schwartz
オライリー・ジャパン / ?円 ( 2003-12 )


FF12ちょっとすすんだ

レイスウォールのデモンズウォールが倒せなくて、あまりにもつまらんので一ヶ月くらいほっといたFFXIIだけど、淡々とLP稼ぎをやってたら、

バン、パンネロ★★★、その他★★

というミストナックレベルに。

やってるうちに、ライセンスのマス目を埋めるのが楽しくてしまった。

プレイ初期でマス目全埋めしたツワモノとかいるんだろうナァ。