数式を書く時にめんどいので、はてなにならってmimetexを入れてみた。
慣れれば楽なのかな。
本に茄子は花が咲いたら上から二つを残してわき芽をかいて三本仕立てにすべしとあったので、今朝早起きして早速かきにいった。
加茂茄子だけどな。
20052009 life
文章が読みにくい。U隊長は苦行だといってた。
投資のすすめ。リターンを生むようなものをこつこつ貯める。そんな感じ。 いずれにせよ、手を動かさなくてもある程度一定の見返りが得られるような 仕組みは必要だろう。
それを、自給という道に求めれば半農半Xかな。
レアなキャリアを持てば、会社に対してもある程度通しやすいものがあるし、しょうもない仕事を嫌々やる必要もないし。
結局、何かへ極度に依存することを避け、選択肢を広げておくために色々工夫をしろということかな。
19052009 life
TOEICのアンケートに答えたら図書カードがもらえたので。
amazonでの評価はあまりよろしくないようだが、僕は結構面白かった。考えるための材料が対談のあちこちに散らばっていたので。
1章の竹中平蔵さんと3章の太田忠さんは普通に面白かったが、4章の「金融から未来を変える」はかなりよかった。
4章読み始めた時はなんでこんなしょうもないのをここにもってくるのかな?と不思議だったが、読み進めていくにしたがい、あーそういう風に考えるのかと思った。ただ一方で、その目指している方向を実現するには、もっと小規模なというか規模を追求しないスタンスの会社でないとサステイナブルな社会というのはなかなか難しいのではないかなぁと思った。
副題に金融リテラシーとか書いてあるけど、これってどっちかというと生き方指南だよなぁと思ったが、よくよく考えてみるにこれはトートロジーではないかと妙に納得した。
ので、酒飲んで寝よーっと。
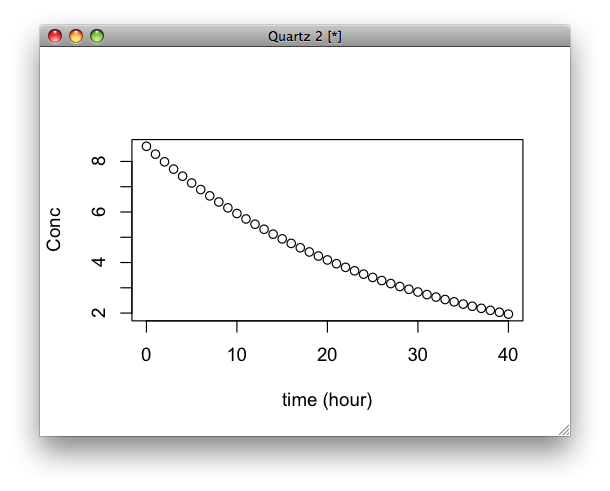
微分方程式を解くためにodesolveを利用する。初期値の与えかたとか、ぐるぐる回していくイメージをつかむのに微妙に時間がかかったが、覚えてしまうと簡単な方程式を解かせたりシミュレーションするのには楽になる。
吸収過程を考えないコンパートメントモデル
library(odesolve)
params <- c(kel = 0.037)
times <- c(0,(1:40))
dydt <- function(t,y,p){
  kel <- p['kel']
  y <- -kel*y
  list(c(y))
}
y <- lsoda(c(y = 8.6),times,dydt,params)
plot(y,ylab="Conc",xlab="time (hour)")
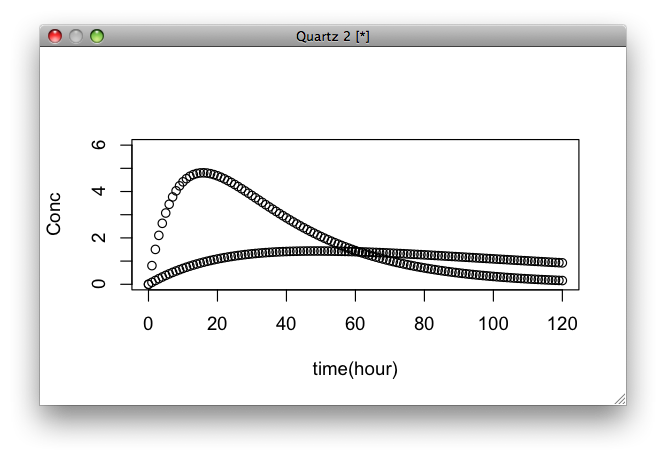
今度は吸収過程を考える。設問3は吸収速度定数を1/10にした時にどういう挙動を示すか。
params <- c(kel = 0.037,ka = 0.1, D = 5000, V = 580)
times <- c(0,(1:120))
dydt <- function(t,y,p){
  kel <- p['kel']
  ka <- p['ka']
  D <- p['D']
  V <- p['V']
  y <- ka * (D/V) * exp(-ka*t) -kel*y
  list(c(y))
}
y <- lsoda(c(y = 0),times,dydt,params)

params2 <- c(kel = 0.037,ka = 0.01, D = 5000, V = 580)
y2 <- lsoda(c(y = 0),times,dydt,params2)

plot(y,ylim=c(0,6),ylab="Conc",xlab="time(hour)")
par(new=T)
plot(y2,ylim=c(0,6),axes=F,xlab="",ylab="")
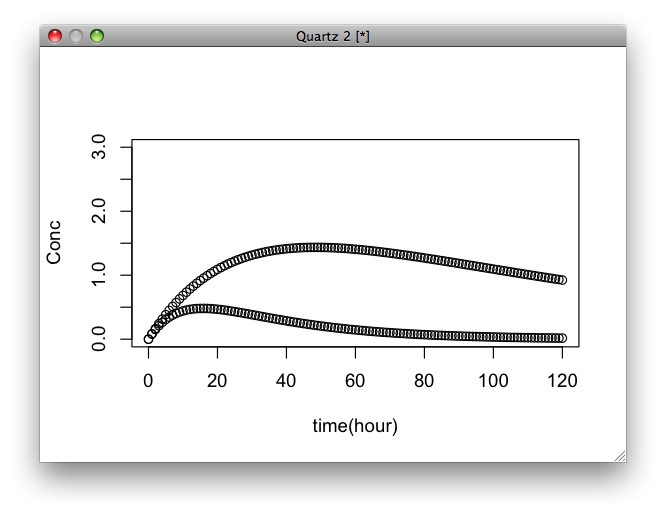
今回バイオアバイラビリティ(F)を1とおいているが、これを変化させた時の挙動も気になるのでやってみた。設問の式にFを組み込んでF=0.1とした時の結果
dydt2 <- function(t,y,p){
  kel <- p['kel']
  ka <- p['ka']
  D <- p['D']
  V <- p['V']
  F <- p['F']
  y <- ka * (D/V) * F * exp(-ka*t) -kel*y
  list(c(y))
}

params3 <- c(kel = 0.037,ka = 0.1, D = 5000, V = 580, F = 0.1)
y3 <- lsoda(c(y = 0),times,dydt2,params3)

plot(y2,ylim=c(0,3),axes=F,xlab="time(hour)",ylab="Conc")
par(new=T)
plot(y3,ylim=c(0,3),axes=F,xlab="",ylab="")
あーなるほど、そうだよなぁと一人で妙に納得したのであった。
先日カットに行った時に美味しい店の話になって、
ブログで見かけた美味しそうな店はブックマークでリスト化してる
とかそういう話をした。
それにしても見ているブログがかぶるなぁと思い、帰ってきてからローカルネタのブログを数えたら120件くらいしかなかったので意外と少ない(と思ったがローカルネタにカテゴライズしてないブログもあるのでそういうの入れたら200件くらいにはなるか)。というより、よくよく考えてみるに食べ物関係のブログがかぶっているだけか。まぁ三島、沼津は少ないので、簡単に収束してしまうような気もする。
さらに、リスト化してるだけで、実際に行けてないんですよねー的な話もしていて、さすがに、これじゃいかんときちんとタグふって管理してみることにした。
ブログに貼付けやすいようにmarkdownで出力
use URI;
use XML::Feed;
use Encode;

my $feed = XML::Feed->parse(URI->new('http://b.hatena.ne.jp/kzfm/rss?tag=kdi'))
  or die XML::Feed->errstr;
print $feed->title, "\n";
for my $entry ($feed->entries) {
  my $title = encode('utf8',$entry->title);
  my $link = $entry->link;
  print "- [$title]($link)\n";
}
これで、月に一回くらいまとめておけば、食欲が刺激されて吉。行ったとこにはitktとかタグふれば、達成率も管理できて尚よい。
あと、美容師さんのお薦めを聞いていたら、OPERAにいかねばならん気にさせられた。
18052009 DMPK
17052009 R
odesolveを覚えるためにロトカ=ヴォルテラの方程式サンプルを。
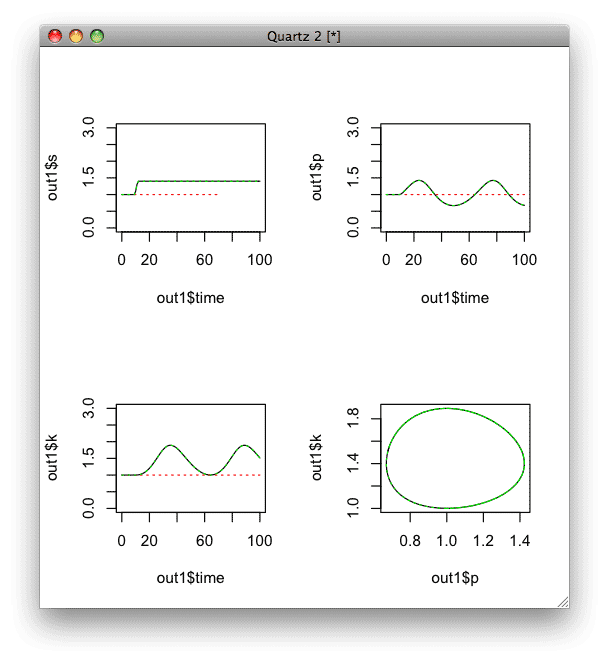
lvmodel <- function(t, x, parms) {
s <- x[1] # substrate
p <- x[2] # producer
k <- x[3] # consumer
with(as.list(parms),{
import <- approx(signal$times, signal$import, t)$y
ds <- import - b*s*p + g*k
dp <- c*s*p - d*k*p
dk <- e*p*k - f*k
res<-c(ds, dp, dk)
list(res)
})
}
## vector of timesteps
times <- seq(0, 100, length=101)
## external signal with rectangle impulse
signal <- as.data.frame(list(times = times,
import = rep(0,length(times))))
signal$import[signal$times >= 10 & signal$times <=11] <- 0.2
## Parameters for steady state conditions
parms <- c(a=0.0, b=0.0, c=0.1, d=0.1, e=0.1, f=0.1, g=0.0)
## Start values for steady state
y<-xstart <- c(s=1, p=1, k=1)
## Classical RK4 with fixed time step
out1 <- as.data.frame(rk4(xstart, times, lvmodel, parms))
## LSODA (default step size)
out2 <- as.data.frame(lsoda(xstart, times, lvmodel, parms))
## LSODA: with fixed maximum time step
out3 <- as.data.frame(lsoda(xstart, times, lvmodel, parms, hmax=1))
par(mfrow=c(2,2))
plot (out1$time, out1$s, type="l", ylim=c(0,3))
lines(out2$time, out2$s, col="red", lty="dotted")
lines(out3$time, out3$s, col="green", lty="dotted")
plot (out1$time, out1$p, type="l", ylim=c(0,3))
lines(out2$time, out2$p, col="red", lty="dotted")
lines(out3$time, out3$p, col="green", lty="dotted")
plot (out1$time, out1$k, type="l", ylim=c(0,3))
lines(out2$time, out2$k, col="red", lty="dotted")
lines(out3$time, out3$k, col="green", lty="dotted")
plot (out1$p, out1$k, type="l")
lines(out2$p, out2$k, col="red", lty="dotted")
lines(out3$p, out3$k, col="green", lty="dotted")
参考
やさしい Lisp の作り方 by Java and by C#を参考に書いてみる。
sub fun {
  my ($self, $arguments) = @_;
  my $arg1 = $self->eval->eval($arguments->cdr)->car;
  my $sym = $arguments->car;
  $sym->value($arg1);
  $self->env->put($sym,$sym->name);
  return $arg1;
}
束縛するものがリストだと、まだうまくいかない。
Moosp> (setq a 5)
5
Moosp> (setq b 2)
2
Moosp> (+ a b)
7
Moosp> (setq c (+ 1 2))
Attribute (value) does not pass the type constraint because: Validation
failed for 'Moosp::Sexp' failed with value Moosp::List=HASH(0xa2a110) at lib/Moosp/Function/Setq.pm line 22
Moosp::Function::Setq::fun('Moosp::Function::Setq=HASH(0xa208a0)',
'Moosp::List=HASH(0xa29a80)') called at lib/Moosp/Eval.pm line 93
Moosp::Eval::eval('Moosp::Eval=HASH(0xa1dcc0)',
'Moosp::List=HASH(0xa29fa0)') called at lib/Moosp.pm line 67
Moosp::run('Moosp=HASH(0x804320)') called at moosp.pl line 7
演習の本をRでこなしていくことにした。
β層の消失速度をもとめて、それを用いてα層の消失速度を決定する。
t <- c(1,2,3,6,13,23,30,39,49)
c <- c(68.2, 51.1, 43.2, 34.0, 18.3, 11.5, 10.7, 10.6, 6.78)
23時間からの濃度からβ層の消失速度を求める
logc <- log(c)
result <- lm(logc[6:9] ~ t[6:9])
coef(result)
 (Intercept)      t[6:9]
 2.93770720 -0.01888941
β層の消失速度が決まったので、次は23時間までの濃度からβ層の寄与を引いた濃度からα層の消失速度を決定する
beta <- function(t){exp(2.937707-0.01889*t)}
alogc <- c[1:5] - beta(t)[1:5]
aresult <- lm(alogc ~ t[1:5])
これでα層β層それぞれの消失速度がもとまる
result

Call:
lm(formula = logc[6:9] ~ t[6:9])

Coefficients:
(Intercept)       t[6:9]
    2.93771     -0.01889

aresult

Call:
lm(formula = alogc ~ t[1:5])

Coefficients:
(Intercept)       t[1:5]
     3.9916      -0.2088
求めるモデルは
exp(3.9916-0.2088*t)+exp(2.937707-0.01889*t)
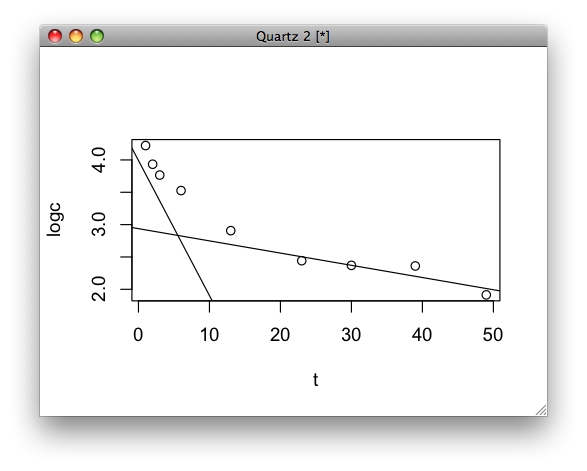
ラフに求めたA,B,alpha,betaを初期値として最小自乗法でフィッティングを行う。1exp,2expでやってみて、どっちのあてはまりがよいか考える
t <- c(1,2,3,6,13,23,30,39,49)
conc <- c(68.2, 51.1, 43.2, 34.0, 18.3, 11.5, 10.7, 10.6, 6.78)
dat <- data.frame(conc,t)
result <- nls(conc ~ a*exp(-alpha*t),start=list(a=50,alpha=0.045))
summary(result)

Formula: conc ~ a * exp(-alpha * t)

Parameters:
      Estimate Std. Error t value Pr(>|t|)
a     63.26990    5.39879  11.719 7.45e-06 ***
alpha  0.08359    0.01777   4.706  0.00219 **
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 6.608 on 7 degrees of freedom

Number of iterations to convergence: 14
Achieved convergence tolerance: 7.74e-06

f <- function(t){63.2699*exp(-0.0836*t)}
plot(f,0,50,xlim=c(0,50),ylim=c(0,70),xlab="Time",ylab="Conc")
par(new=T)
plot(t,conc,xlim=c(0,50),ylim=c(0,70),axes=F,xlab="",ylab="")
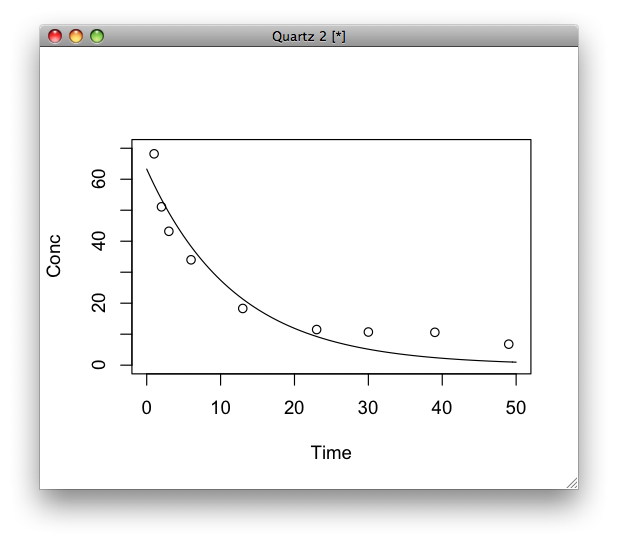
一層の消失モデルだと特に遅い時間の当てはめが悪い。ちなみにRだとAIC関数使えば適合度がでる。
t <- c(1,2,3,6,13,23,30,39,49)
conc <- c(68.2, 51.1, 43.2, 34.0, 18.3, 11.5, 10.7, 10.6, 6.78)
dat <- data.frame(conc,t)
result <- nls(conc ~ a*exp(-alpha*t)+b*exp(-beta*t),start=list(a=50,alpha=0.277,b=20,beta=0.0198))
summary(result)
f <- function (t){55.75*exp(-0.3769*t)+29.157*exp(-0.03189*t)}
plot(f,0,50,xlim=c(0,50),ylim=c(0,70),xlab="Time",ylab="Conc")
par(new=T)
plot(t,conc,xlim=c(0,50),ylim=c(0,70),axes=F,xlab="",ylab="")
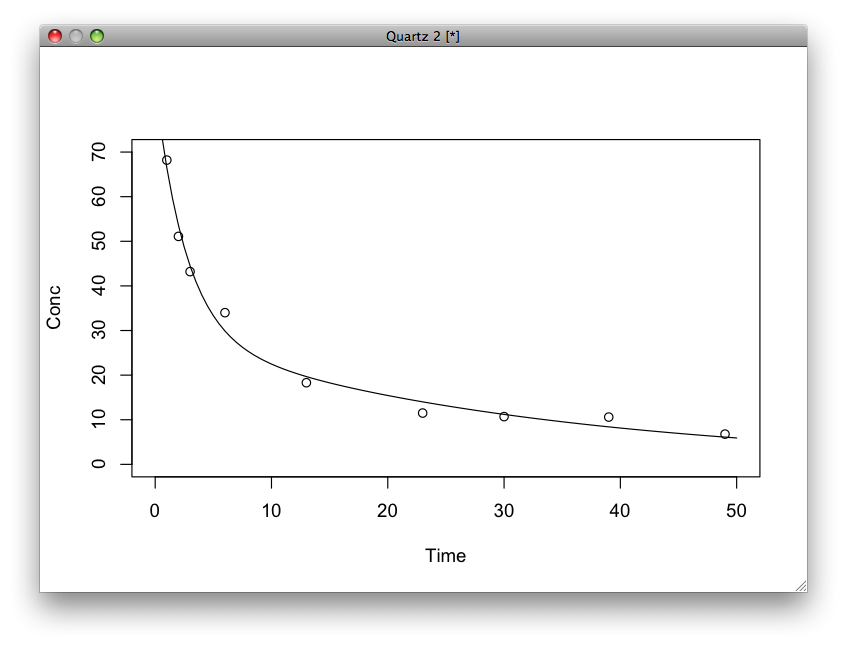
プロットするときにpar関数で上書きするのと、xlim,ylimを明示して軸をきちんとそろえつつ、目盛やタイトルを上書きして重ねないように気をつける。
 現代にいきづく京の伝統野菜 古都の食文化を担って
 金持ち父さん貧乏父さん
 半農半Xという生き方 (ソニー・マガジンズ新書)
 勝間和代のお金の学校―サブプライムに負けない金融リテラシー
 ファーマコキネティクス―演習による理解
 分子薬物動態学