24082009 life
本は薄いのに、内容は濃い(というかわからん)。未知の領域。
 計算統計入門 代数生物学―大規模・高精度計算が拓いた新技法 (現代技術への数学入門シリーズ)
記号計算による代数的手法を用いなければわからないような自然現象の理解に力点を置く。
- チョムスキー階層と単細胞から多細胞への進化を関連させる。
- 有限言語、正規言語、文脈自由言語、文脈依存言語、帰納的可算言語
- 形式言語理論の一分野であるリンデンマイヤシステムをもとに再生モデルを構築
- ゴキブリの脚の挿入再生モデル
- グレブナー基底
Singularという計算機代数システムがあることを知った。
24082009 life
23082009 work
macbookにpowerpoint(プレゼン用)入れたら、Let's note R4がWindowsである必要はなくなってしまったので、Ubuntuでも入れるかと。
UNetbootinを使うとisoイメージをusbメモリからインストールできるんだが、これが超らくちんで、あっさりインストール完了。
無線LANの認識もスムース。
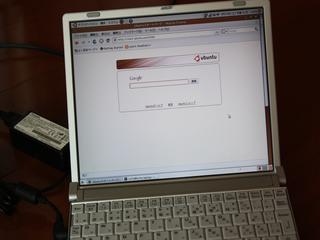
あとはemobile使えるんだったら、持ち歩きはこれでいいや。
22082009 music
ゴーヤの種取り。発芽率が低いらしいのであと一個分くらいは種取りをしておきたい。
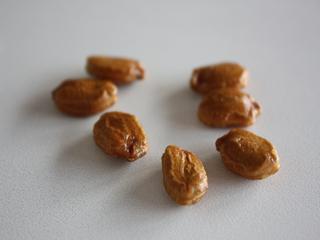
左から唐辛子、シソ、ゴーヤ、モロヘイヤ(初収穫)
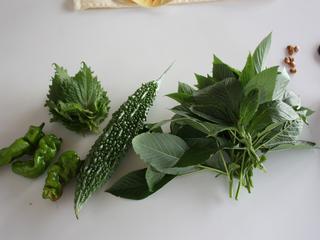
モロヘイヤの種にはストロファンチジン(Strophanthidin)という毒があるらしい。

20082009 q-chem
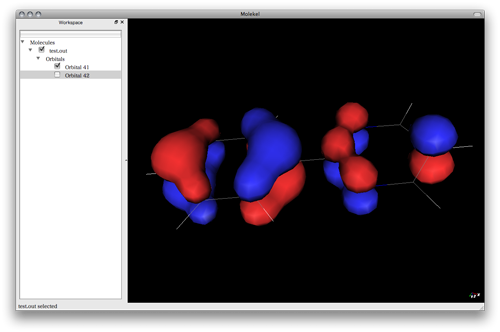
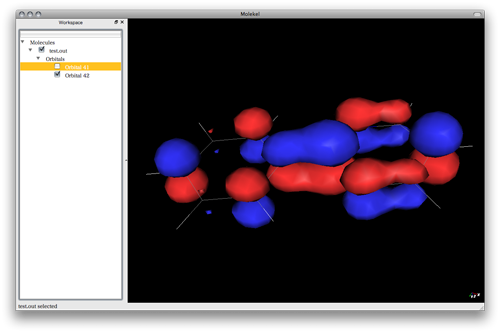
biphenylの立体構造はお互いのオルト位の水素がぶつかるのでねじれているんだけど、まぁそれはSTO-3Gで計算してもねじれてる構造が出てきた。
じゃぁ、水素じゃなければいいのか?ってことで片方をpyrimidineにしてみたら奇麗に平面になった(STO-3G)
ついでにHOMO,LUMOくらいも見てみた。
HOMO
LUMO
オチなし。
19082009 chemoinformatics macbook
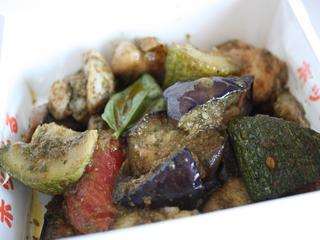
夏野菜の揚げ浸しとユーリンチー
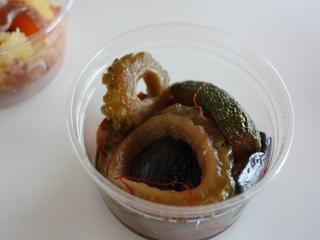
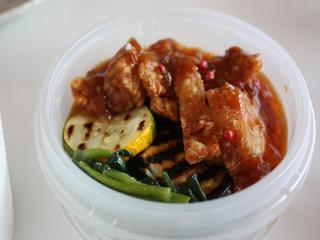
バジルペーストのやつと、鱒とレッドムーンのマリネ
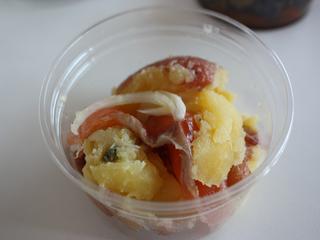
僕的には鱒とレッドムーンのマリネが超お気に入り。これはマジで美味いですな。これをつまみに、、(略)
揚げ浸しのゴーヤが輪切りだったのも参考になった。というか、いつも縦に切ってざくざく切ってたので、他の切り方が思いつかなかったという、、、
水産資源学におけるベイズ統計の応用ワークショップのスライドの22,23枚目
となっているのだが、23枚目のRのコードは
n2 <-sample(length(x1), 1000, replace=T, prob=dlnorm(x1,1.1,0.6))
とwを求めずにいきなりサンプリングしているので?となったが、一様分布だから重みを計算する必要ないのね。
わざわざ書くならこうか。
x1 <-runif(100000,0,60)
w <- dlnorm(x1,1.1,0.6) / (dunif(x1,0,60))
n2 <-sample(length(x1), 1000, replace=T, prob=w)
x2 <-x1[n2]
plot(density(x2))
 キーポイント微分方程式 (理工系数学のキーポイント)
 キーポイント熱・統計力学 (物理のキーポイント (3))
 フーリエ解析と偏微分方程式 (技術者のための高等数学)
 キーポイントフーリエ解析 (理工系数学のキーポイント (9))
 パターン認識と機械学習 下 - ベイズ理論による統計的予測