MS的リテラシが低いことに気づかされた

まったくもってエクセルは使いづらい。ウェットからまわってきたピボットデータをRで処理するために、デピボットすんのにセルをマウスで移動しながら、、、、ペコペコペコペコ貼り付ける。

20分ぐらいは耐えたけど、イライラが閾値を超えたのでグーグルで調べたら、そういう機能はないけどもうちょっとマシなやり方はみつけた。

[Excel]横方向に入力したデータを縦方向に並びかえる操作

横方向に入力したデータを、直接縦方向に並び替える機能はありませんが、セルを横方向にコピーして別の場所に縦方向で貼りつけるという操作は可能です。

Ctrl-C, Alt-E,S,E, Ctrl-Mでキーボード操作。

元データは(できれば正規化して)スプレッドシートにまとめておいてくれれば、再利用性があがるのに~と思いながら潰した半日だったヨ。

chemicho

昔作ったコードが気に入らなかったので書き直したら、そこそこ動くようになったので、Chemicho-0.01.tar.gzとしてダウンロードできるようにしておいた。これはPerlMolを使って実装された化合物にランダムに変異を入れていくツールで、例えば、H2Lでヒット化合物に修飾を軽く加えてみたりとかしてくれる、ケミストチックな小人さんに育つことを期待してるわけだ。

  • AddCarbon(メチル基付加)
  • Aromatize(ジエンを芳香環化)
  • DeAromatize(芳香環をジエン化)
  • DecreaseBondOrder(結合次数を減らす)
  • GenerateRing(環化)
  • Halogenize(メチルをハロゲンに)
  • IncreaseBondOrder(結合次数を増やす)

設定はYAMLで。

Generationは世代数で、cycleは世代で生成される化合物の数。ちなみに第0世代は親。例えばcycle3で第三世代まで発生させると3^3で27化合物で4世代目には3^4で81化合物できる。ランダムな置換の頻度はweightで変えられるようになってる。

reactionはSMARTS使ってこんな感じで反応させてる。

いまんとこ、変異用のモジュールが少ないのでバリエーションが少ないのだけど、これから増やす予定。あと、cycle間で重複を許しているのでこの部分は改善する。

TODO

  • コンバーター作成
  • c1ccccc1 をc1cscc1に変える
  • 極性基の導入、削除
  • エステル化
  • 芳香環に極性基の導入
  • その他
  • 重複チェック
  • オブジェクトをsmilesにしてsqliteで管理する
  • QSAR的なツールと絡めて、変異の頻度を自由に変えられるように。(例えばclogpがでかくなったら極性導入の頻度を高くしたり、MWTが大きくなりすぎたら、大胆に削るとか)
  • wikiかなんかにちゃんとしたドキュメントとか書く。

PerlMolの作者はAnnoCPANの作者でもあったのね

AnnoCPAN

知らんかった。というかAnnoCPAN自体ちゃんとわかっていなかったので読んでみた。

なかなか面白そうなので、アカウントもとってみた。

PerlMolでSMARTS

Chemistry::File::SMARTS Version 0.22

基本的な事柄

implicit,explicit
implicit:明示的に指定されていないbondとか(水素)原子も含んだ完全な形で。
smiles記法では(明らかに省略できる)水素原子は省略するのでexplicit,implicitという区分けがある。MOLもそうだけど。

などを参照するとイメージはわかるはず。

patern match check

パターンマッチの確認は以下のコードでおこなった。

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
#!/usr/bin/perl

use warnings;
use strict;
use Chemistry::File::SMARTS;
use Chemistry::File::SMILES;
use Chemistry::Ring 'aromatize_mol';

my ($SMARTS,$SMILES) = @ARGV;
print "SMARTS: $SMARTS\n";
print "SMILES: $SMILES\n";

my $pattern = Chemistry::Pattern->parse($SMARTS, format => 'smarts');
my $react = Chemistry::Mol->parse($SMILES, format => 'smiles');
aromatize_mol($react);

my $count = 0;

while ($pattern->match($react)){
    $count++;
}

print $count,"\n";

Atomic Primitives

  • *
    全ての原子にマッチ

  • a,A
    Aromatic(a) or Aliphatic(A)。 PerlMolではChemistry::Ringでaromatize_molしとかないと認識しない。

  • D<n>,X<n>,x<n>
    結合原子数(n)を有するAtomにマッチ。明示的(D)か、内在的(X)か。つまり、Dは明示的にHとの結合が指定されていない限りこれをカウントしない。xはリングのコネクティビティだが、PerlMolではサポートされてないっぽい。

  • H<n>,h<n>
    明示的なHをカウントする(H)か内在的なものも含めるか(h)

  • R<n>,r<n>
    n原子からなるSmallest Set of Smallest Rings (SSSR)のメンバーにマッチ(R)。PerlMolだとRかどうかだけしか判断していないので<n>は関係ないかも。リングサイズが最小のSSSRのメンバーにマッチ(r)。芳香環かそうでないかは判断せず、n員環のメンバーであればマッチ

こんな感じ

$ ./smartstest [r6] 'C1CCCCC1CCC' # 6
$ ./smartstest [r6] 'c1ccccc1CCC' # 6
$ ./smartstest [r6] 'c1cc1CCC'    # 0
$ ./smartstest [r3] 'c1cc1CCC'    # 3
  • v<n> バレンス。いわゆる手を伸ばせる数(Nは3で、Cは4)

  • <n>,+<n>,#n チャージの有無と原子番号

  • @,@@,@<c><n>,@<c><n>? キラルはPerlMolではサポートされてない。

Bond Primitives

  • -,=,#,: 一重結合(-)、二重結合(=)、三重結合(#)、芳香属性の結合(:) aromatizeしてるのに二重結合がカウントされるのがわからん。局在化した芳香環の二重結合だけ読んでるっぽいので、SMARTS書くとき注意

下の例

$ ./smartstest "c:c" 'c1ccccc1'
SMARTS: c:c
SMILES: c1ccccc1
6
$ ./smartstest "c=c" 'c1ccccc1'
SMARTS: c=c
SMILES: c1ccccc1
3
$ ./smartstest "c-c" 'c1ccccc1'
SMARTS: c-c
SMILES: c1ccccc1
0
  • ~,@ ワイルドカード(~)、リング結合全て(@)

  • /,,/?,? PerlMolでサポートされてるかどうか調べてない(とりあえず使わないので後回し)

Logical Operator

  • !,&,,(commma),;

否定(!),論理積(&,; ただし、&は最初に評価される),論理和(,)

Component-level grouping

PerlMolではサポートされていない

こういうのをblogに突っ込むのは無理がある。素直にWiki+Markdown入れようと思ったヨ。
bioのDBをActiveRecordで

第3回オントロジー研究会の、ActiveRecord によるバイオデータベースモデリングという演題が気になるが、別のとこ行くのでちと出れない。

ActiveRecordってテーブル-モデルが一対一なんでしょ?だから、親子関係をシングルのテーブルにすんのめんどくさくないんじゃろかとかが知りたかったんだけど。

あとで、トレースしよう。それからSwissknifeも使ってみる。

Structure-CDKをperlで使う

smilesを描画するwebのインターフェースが欲しくて、色々作ってみた

必要なもの

ここら辺を参考に書いた。できたものはCDK-Util-0.01.tar.gzにおいておいた。

  • smi2mol
  • smi2png
  • IUPAC2CML

が可能。IUPAC2PNGも書いたのだけどmake testで豪快にこけるので無視してインストールしてください。podの細かいとこも気にしないように。Iupac2Pngはcdkでcmlをmolに変換するあたりがわからなくてあきらめたけど、そこのコードの部分だけ手直しすれば動くと思う。

っていうか、iupac2pngはopenbabelのモジュール使えばいいじゃんって気付いた途端もういいやってなってしまった。書式コンバートはopenbabelのほうがわかりやすい。ちょっとコード量は増えるけど、こんな感じ。

use strict;
use warnings;
use CDK::Smi2Png;
use CDK::Iupac2Cml;
use Chemistry::OpenBabel;

my $iupac_name = shift;
my $ic = CDK::Iupac2Cml->new();
my $cml = $ic->convert($iupac_name);

my $obMol = new Chemistry::OpenBabel::OBMol;
my $obConversion = new Chemistry::OpenBabel::OBConversion;
$obConversion->SetInAndOutFormats("cml", "smi");
$obConversion->ReadString($obMol, $cml);

my $smi = $obConversion->WriteString($obMol) or die "$! not converted";

$smi = (split(/\t/, $smi))[0];

my $smic = CDK::Smi2Png->new();
$smic->writePNG($smi,200,200,'/home/kzfm/test.png');

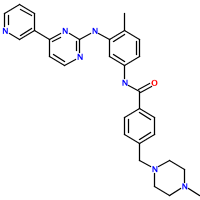
で実行する。Imatinibくらいは認識するようだ。

./iupac2png.pl  "4-[(4-methylpiperazin-1-yl)methyl] \
-N-[4-methyl-3-[(4-pyridin-3-ylpyrimidin-2-yl)amino] \
-phenyl]-benzamide"

Imatinib

あとはcatalystとsmi2pngを組み合わせて、chemichoのwebインターフェースに使ったり、iupac2pngでcgiでもつくってbookmarkletでポストできるようにしとけばpubmedとかのIUPAC名をいつでもひける。辞書サーチのプラグインで右クリック呼び出しでもいいけど。

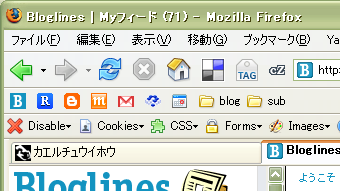
firefoxの個人用ツールバーフォルダ

個人用ツールバーフォルダにつけてるボタンは名前を空欄にしたほうがアイコンチックになってすっきりしてみやすいことにいまさら気付いた。

toolbar

ブックマークレットもアイコンにならんもんじゃろか?増えてくるとあれ~~?とか一瞬悩むことは増えるので。

CDKで型があわねーとかいうエラー

Depth-FirstでみっけたStructure-CDKが使いたいということでcdk-20050826.jarからcdk-20060714.jarにあげたらこの前つくったモジュールが動かなくなった。

sdg.setMolecule(mol);
sdg.generateCoordinates();
mol = sdg.getMolecule();

のところで、

Smi2Mol_899b.java:49: 互換性のない型
検出値  : org.openscience.cdk.interfaces.IMolecule
期待値  : org.openscience.cdk.Molecule
        mol = sdg.getMolecule();
                             ^
エラー 1 個

もげー、型が違うってなんでじゃ?

CatalystのTTでeval_perl

Catalystの設定ファイルのyamlにEVAL_PERLを入れておくとTTでperlのコードが使える。

      INCLUDE_PATH:
              - 'root/templates'
      TEMPLATE_EXTENSION: '.tt'
      EVAL_PERL: 1

とかやっておくと

[% PERL %]
    print $stash->{tags};
[% END %]

みたいに書ける。

やりたいことはちょっとした加工だったので、ホントはvirtual method使いたかったのだけど、catalystのどの部分でdefine_vmethod呼べばいいのかイマイチわからなかった。

それにしてもTTでperlのコード書くのはちょっと気持ち悪い。

DBIx::Classを使ってみた

いまいち、Class::DBIとDBIx::Classの違いがわかっていないのだけど、Catalystで作りたいものがあったので Perl/DBICなどみながら、いろいろさわってみてる。

My Kwiki: HomePage

Class::DBI inspired ORM designed to be resultset-oriented rather than table-oriented - so native support for views, aggregates (GROUP BY etc.), better automatic JOIN-ing and the ::Sweet search features done properly.

Class::DBIがテーブル指向なのに対して、DBIx::Classはresultset指向らしい。確かにCDBIだとページの処理用にプラグインがあったりするけどDBIx::Classだとさくさく書けた。

もうちょいドキュメント 読む必要があるけど、なかなか楽しげ。

ちなみに、下の二つは同じらしい。今日書いててちょっと悩んだのでメモ

$c->model('DBIC')->resultset('Items')

2006.10.17追記

DBIx::Class::Manual::Glossary - Clarification of terms used. - search.cpan.org

ResultSet

This is an object representing a set of data. It can either be an entire table, or the results of a query. The actual data is not held in the ResultSet, it is only a description of how to fetch the data.

ResultSetとはデータセットを表すオブジェクトで、テーブル全体であったり、クエリの結果だったりする。