28082006 firefox
あれ、LSDって昔はpdic形式のデータ配布してたよなァと思いつつ、探してもみつからないので英辞郎みたいに右クリックで検索できるようにしてみた。
http://lsd.pharm.kyoto-u.ac.jp/cgi-bin/lsdproj/ejlookup04.pl?query=$
を拡張機能で設定。
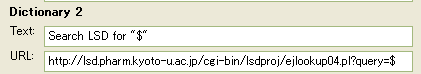
で、実行すると新しくタブが開いて検索結果が表示されるようになったとさ。
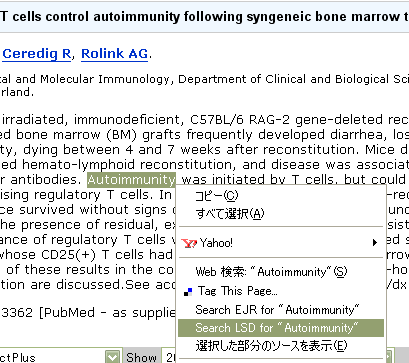
pubmedのアブストをRSSリーダーで流し読みしてるときなど便利。
28082006 firefox
あれ、LSDって昔はpdic形式のデータ配布してたよなァと思いつつ、探してもみつからないので英辞郎みたいに右クリックで検索できるようにしてみた。
http://lsd.pharm.kyoto-u.ac.jp/cgi-bin/lsdproj/ejlookup04.pl?query=$
を拡張機能で設定。
で、実行すると新しくタブが開いて検索結果が表示されるようになったとさ。
pubmedのアブストをRSSリーダーで流し読みしてるときなど便利。
27082006 Python
メタモ前に時間が空いていたので、みんなのpython全部読んでしまった。
一通り読んで、doctestって便利な仕組みだとプチ感動。あと、リスト内包表記が使えるので便利そうだけど、表記の仕方がhaskellのほうが(見た目)わかりやすいかなってとこ。
Rとかbiopythonみたいな科学技術計算関連でちょっと使ってみようと思っているが、その前にTurboGearsとDjangoをさわってみる。
26082006 chemoinformatics R bioinformatics
CRANでRNewsの最新版が読めるようになってた。今号はなかなか興味深い記事が多かった。全部読んでみたけど特に印象深かったのはこの3つ
毒性試験との用量依存性曲線を描くためのコツというかそんな感じの内容。
酵素アッセイとかだと普通にシグモイド曲線のフィッティングをすればいいが、ED50なんかを求める系だと、hormesisがおきるので、特に低用量下でブランクよりも高い値がでる場合がある。そういう場合は linear-logistic modelを導入するとよいらしい。
僕はよく使うので、multi-response modelsのとこと、varidation周りの話題が参考になった。
RからCDKを使う話。SJavaをつかってRから記述子を抽出したりとか画像を表示したりとか。僕はRから他の言語を使おうとはあまり思わないほうなので参考になったという感じ。むしろ、jython+CDKとRpyを組み合わせて色々できると面白いナァと思う。
Higher-order Perlの4章を読み終わった。iteratorの章だが100ページ近くあってなかなかの読み応えでちょっと読み疲れた。
 Higher-Order Perl: Transforming Programs with Programs
さぁ、5章だと思ったら、みんなのpythonが届いた。
うーん読む暇をみつけないといけないが、haskellのあとだなぁ。
24082006 mopac
サーバーにMOPACを入れてみた。C3だからどうかなぁなどと思っていたが、なかなかさくさく動くので結構満足
MOPACの利点は、半経験的……シュレーディンガー方程式を一から解くのではなく、計算途中で 経験的パラメータを部分的に導入し、計算コストを下げるという点です。MOPACなら現在の 家庭用PCでも十分計算が可能で、それほど待つことなく計算結果を見ることができます。 しかし、それで計算精度が大きく低下することもありません。MOPACで使用されているパラメータ は既存の数多くの有機分子の構造パラメータで最適化されていて、通常の有機分子を計算する 分には、十分な精度の結果を与えます。
とはいえ、このままだとアウトプットの解釈がしにくいナァ。SMBと組み合わせて、可視化はWINでするとか。そんな対応しか思いつかんヨ。
23082006 chemoinformatics soap
クライアントじゃなくてサーバーのほうをSOAP::Lite for Perlを参考に勉強中。久々の仕事絡みのプログラミングだ。
うちはケモインフォ関連の記述子発生ソフトや3次元構造立ち上げツールが複数のサーバーに分散されているという環境なので、rsh全開力技のスクリプトを書かないとフローが処理できない。でも、最近のツールにはSOAPじゃないと使えないのがあったり、あんまガシガシ書くとメンテが大変だったりするので、よく使うスクリプトはモジュール化しつつ、SOAPに対応することにした。
実はSOAPでサーバー側のスクリプト書くのは初めてで、色々悩むとこが多いなぁという感じ。特に記述子発生ツールはsmiles一化合物ごとに処理すると通信のオーバーヘッドが馬鹿になんないんじゃないの?だから束ねて計算させたほうがいいのかなとか、mopacとかgamessとか構造最適化みたいに意外に時間がかかる処理はどうしようかな?と。要するに非同期通信させないと駄目なんじゃないということなんですが。
で、いろいろ探し回ったところ、非同期にメソッドを実行するには?という遺伝研メソッドを発見。ほお、イメージとしては大分昔のNCBIがBLASTをリフレッシュ使って実装してたようなので捉えればいいのかな?
あとはSOAP::Liteでオブジェクトアクセスしたときにエラーハンドリングはどうやるんだろうか?やっぱ、関数型のやり取りのほうが、SOAP::Lite以外のクライアントとのやり取りがラクなんだろうなとか感覚的に思うことはあるんだけど、実際に色々作ってみて使ってみないとわからんな。
Inline::Java使っていてjavaのtry-catchってコンパイラに強制されてる感が強くてやだけど構文自体は読みやすくてよいよなと思ってたらperlでもtry-catch構文風なものが使えるようになるモジュールがあるそうだ。
qootas.org/blog - Perlにおけるtry catch
perl についてくるモジュール Error.pm を使うとこんな感じで書けます。
下の記事もわかりやすい。
perl.com: Object Oriented Exception Handling in Perl
The main goal of this article is to discuss in detail about exception handling in Perl and how to implement it using Error.pm. On our way, we'll be touching upon the advantages of using exception-handling over traditional error-handling mechanisms, exception handling with eval {}, problems with eval {} and the functionalities available in Fatal.pm. But by and large, our focus we'll be on using Error.pm for exception handling.
21082006 chemoinformatics perl java cdk
_in house_でケモインフォ関連のプログラミングをするのに、二次元構造の立ち上げツール(またはライブラリ)と、構造描画ツールは必須だが、いまのとこCDKを使うという選択肢しかない。
実用PerlプログラミングにInline::Javaを使うとjavaのコードをperlに組み込めると書いてあったので、CDKを組み込んでみたヨ。
まぁ、要するに、
Q.そこまでしてperlで処理したいのか?
A. もちろんですヨ、奥さん
ということなんだが。
さて、インストールはj2sdkの場所を指定しないといけないのでcpan -iだとこける。そのため地道に、buildディレクトリで再インストール。
$ cd .cpan/build/Inline-Java-0.51
$ perl Makefile.PL J2SDK=/usr/java/jdk1.5.0_08/
$ make java
$ make
$ make test
$ make install
ただ、make javaで
注:入力ファイルの操作のうち、未チェックまたは安全ではないものがあります。
注:詳細については、-Xlint:unchecked オプションを指定して再コンパイルしてください。
とかいう警告が出るが、testは通るのでまぁ気にしないということで。
で、コードを書いてみる。
参考にしたjavaのコード
:::java use Inline Java => <<'END_OF_JAVA_CODE' ; import java.io.StringWriter; import java.io.IOException; import org.openscience.cdk.Molecule; import org.openscience.cdk.exception.CDKException; import org.openscience.cdk.io.MDLWriter; import org.openscience.cdk.smiles.SmilesParser; import org.openscience.cdk.layout.StructureDiagramGenerator; import org.openscience.cdk.tools.HydrogenAdder;
class smi2mol{

    public smi2mol(){
    }

    public String convert(String smi){
    Molecule mol = null;

    try {
        SmilesParser sp = new SmilesParser();
        mol = sp.parseSmiles(smi);
    }catch (Exception ise){
        ise.printStackTrace();
    }

    StringWriter w = null;
    MDLWriter  mw = null;

    try {
        w = new StringWriter();
        mw = new MDLWriter(w);
    } catch (Exception e) {
        e.printStackTrace();
    }

    HydrogenAdder ha = new HydrogenAdder();
    try{
        ha.addExplicitHydrogensToSatisfyValency(mol);
    } catch (Exception e){
        e.printStackTrace();
    }

    StructureDiagramGenerator sdg = new StructureDiagramGenerator();
        try{
        sdg.setMolecule(mol);
        sdg.generateCoordinates();
        mol = sdg.getMolecule();
        mw.write(mol);
    } catch (Exception e){
        e.printStackTrace();
    }

    return w.toString();
    }
}

END_OF_JAVA_CODE

my $alu = new smi2mol();
my $smiles_string = shift;
print $alu->convert($smiles_string);
実行してみる
::: sh $ perl test.pl "C(=O)O"
  CDK

  5  4  0  0  0  0  0  0  0  0999 V2000
    1.2990   -0.7500    0.0000 C   0  0  0  0  0  0  0  0  0  0  0  0
    0.0000    0.0000    0.0000 O   0  0  0  0  0  0  0  0  0  0  0  0
    2.5981   -0.0000    0.0000 O   0  0  0  0  0  0  0  0  0  0  0  0
    1.2990   -2.2500    0.0000 H   0  0  0  0  0  0  0  0  0  0  0  0
    3.8971   -0.7500    0.0000 H   0  0  0  0  0  0  0  0  0  0  0  0
  2  1  2  0  0  0  0
  3  1  1  0  0  0  0
  1  4  1  0  0  0  0
  3  5  1  0  0  0  0
M  END
水素が付加されて、座標も計算されたMOLファイルが出力される。
javaって例外を返す可能性がある場合try,catch構文入れないと強制的にエラーになるのね。try,catch構文は読みやすいけど、強制されんのはちょっとやだナァと。単にフォーマットをコンバートするだけのコードなのに結構長くなっちゃったし。
::: perl use CDK; use Chemistry::Mol;
my $mol = CDK::smi2sdf($molecule);
print $mol;
みたいにモジュールにしてuseして使えばCDKを意識しなくてよくなる。
19082006 Haskell
コメントでhaskellでフィボナッチの別解をもらったが、パッと見てもなぜこれでフィボナッチ数列ができるのかいまいちわからんかったので、よく読んでみたヨ。
まずは型チェック。 見ればわかるとおりfibはリストを返す関数ですな。つまり、fibを実行するとフィボナッチ数がどんどこどんどことそれこそとめどなく溢れてくる(はず)
fib :: Num a => [a]
fib = 0:1:zipWith (+) fib (tail fib)
これを fib.hsという名前で保存してghciで実行してみる。
$ghci
*Main> :l fib.hs
*Main> fib
をを~。凄い勢いでフィボナッチ数列がどんどこど(以下略)。ちなみにlengthでリストの長さをはかってみると、プロンプトがかえってこないゾ。さすが無限リスト。
zipWithの型とtailの型はこんな感じ。
Prelude> :t zipWith
zipWith :: (a -> b -> c) -> [a] -> [b] -> [c]
Prelude> :t tail
tail :: [a] -> [a]
zipWithは高階関数で、+関数をfibとtail fibに適用して新しいリストをつくるわけですな。tailは先頭の要素を取り除いたリストを返す関数だから、、、うーんやってることはわかるんだけど、イマイチイメージできん。
と悩んでたら、Wikipediaに書き下されてる表をみつけて納得した。perlで同じことやろうとするとまず有限個の要素をもつ配列があってみたいなところから始まるから、こういう表現はできないな。というわけで、目からうろこっていうか、ちょっと感動した。
ここで考えたようなn-1番目とn番目のフィボナッチ数が与えられたときにn+1番目のフィボナッチ数を求めるということを考えるのではなくて、そもそもフィボナッチ数列とは何かを考えて、それを無限リストとして表現することを考えればよいんですよと。
となると、リスト内包表記も感動するような綺麗さダ。
fibs = 0 : 1 : [ a+b | a <- fibs | b <- tail fibs ]
GHCの並列リスト内包表記(GHCの拡張は特別なコマンドラインフラグによって有効にしなければならない。
とあるのが、なにが問題なんだかわからんので、とりあえず実行してやろう。
fib4.hs:1:15: Illegal parallel list comprehension: use -fglasgow-exts
Failed, modules loaded: none.
デフォルトだと、同じリストが複数でてくるような表記の仕方(この場合はfibs)は問題あるということなのかな
ghci -fglasgow-exts
とオプションを指定して実行することで、OK。をを~。凄い勢いでフィボナッチ数列がどんどこど(以下略)。
haskell素敵過ぎ
19082006 music
U隊長がボニピンベストがITMSで買えないんだよねーとか言うので、amazonで。
 Every Single Day -Complete BONNIE PINK (1995-2006)-
僕はEvil and Flowersが好き。
 みんなのPython
 実用 Perlプログラミング 第2版